국대 AI 벤치마크 1위 탈락 — 독파모 2차 평가가 남긴 것
정부의 '국대 AI(독자 AI 파운데이션 모델)' 선발 2차 평가에서, 글로벌 벤치마크 점수 1위를 받은 모티프가 탈락하고 대신 다른 기업이 선정되는 결과가 나왔습니다. 벤치마크 성적이 좋아도 떨어질 수 있다는 이번 사례는, AI 모델을 어떻게 평가해야 하는가라는 질문을 업계에 남겼습니다.
벤치마크 1위가 왜 탈락했나
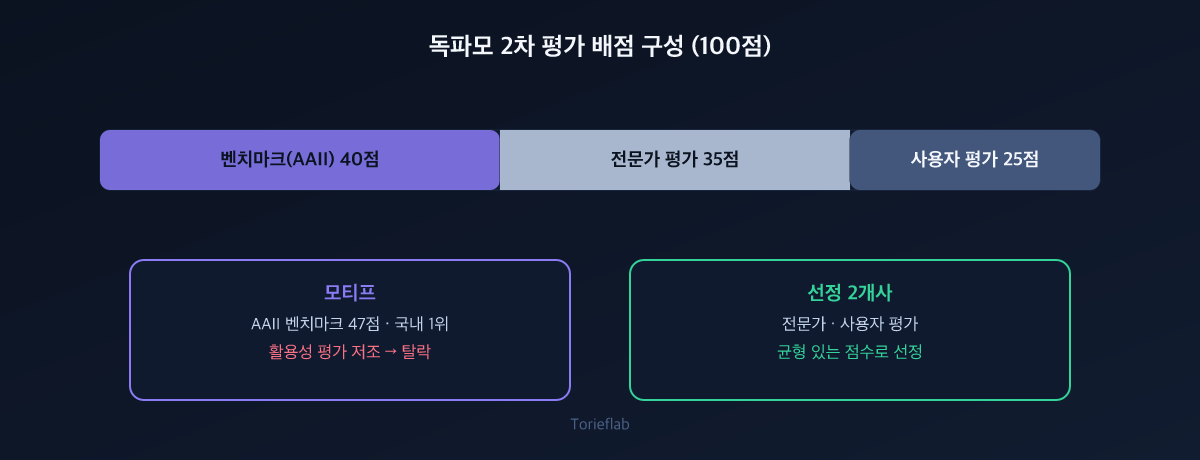
이번 2차 단계평가는 벤치마크 평가(40점), 전문가 평가(35점), 사용자 평가(25점) 세 영역을 합산하는 방식으로 진행됐습니다. 벤치마크 평가는 글로벌 AI 평가기관 아티피셜 애널리시스(AAII) 지표로 단일화했는데, 여기서 모티프가 47점을 받아 업스테이지·SK텔레콤·LG AI연구원을 모두 제치고 국내 최고점을 기록했습니다. 그런데 최종 결과는 예상과 달랐습니다. 모티프는 AI 활용성·사용성 평가에서 상대적으로 낮은 점수를 받아 탈락했고, 정부는 예정대로 2곳을 선정했습니다. 순수 벤치마크 성능과 실제 활용성이 반드시 비례하지 않는다는 걸 보여준 결과입니다.
세부 점수 비공개, 왜 논란이 됐나
정부는 기업별 개별 점수를 구체적으로 공개하지 않고, 항목별 전체 평균 점수와 1위-4위 간 점수 격차만 공개했습니다. 이를 두고 "평가 과정을 투명하게 알려야 한다"는 요구가 업계에서 나왔습니다. 국책 사업 선발 과정에서 세부 평가 기준과 점수가 불투명하면, 탈락한 기업 입장에서는 정확히 어떤 지점에서 부족했는지 파악하기 어렵고, 이는 다음 평가를 준비하는 데도 걸림돌이 될 수 있습니다. 정부는 이번 논란 이후 평가 방식을 일부 조정할 뜻을 시사한 것으로 알려졌습니다.
'벤치맥싱' 논란은 어떻게 정리됐나
이번 평가 과정에서는 '벤치맥싱(benchmaxing)' 의혹도 함께 제기됐습니다. 벤치맥싱은 사전에 공개된 평가 지표에 맞춰 특정 성능만 극단적으로 끌어올리는 행위를 말하는데, 실제 범용 성능과 무관하게 시험 점수만 잘 나오도록 모델을 조정했다는 의심을 받을 수 있는 사안입니다. 과기정통부는 AAII 운영기관에 관련 의혹 검토를 요청했고, 그 결과 벤치마크를 겨냥한 체계적인 암기나 과적합 문제를 입증할 단서는 찾지 못한 것으로 확인됐습니다. 다만 논란이 제기됐다는 사실 자체가, 벤치마크 점수만으로 모델 성능을 판단하는 방식의 한계를 보여준 사례로 남았습니다.
AI 모델을 다루는 개발자가 참고할 점
- 벤치마크 점수와 실사용성은 다른 지표라는 걸 기억해야 합니다. 특정 벤치마크에서 높은 점수를 받았다고 해서 실제 서비스에 붙였을 때 사용자가 체감하는 품질까지 보장되는 건 아닙니다. 모델을 선택하거나 평가할 때 벤치마크 점수 외에 실제 태스크 기반 평가를 함께 봐야 하는 이유입니다.
- 평가 기준 설계 자체가 결과를 좌우합니다. 이번처럼 벤치마크·전문가·사용자 평가의 배점 비중을 어떻게 나누느냐에 따라 최종 순위가 완전히 달라질 수 있어, AI 모델을 비교·검증하는 프로세스를 설계할 때도 평가 항목의 가중치를 신중히 정해야 합니다.
- 벤치맥싱 리스크를 인지하고 있어야 합니다. 특정 벤치마크에 맞춰 모델을 과최적화하면 그 벤치마크에서는 좋은 점수가 나오지만, 실제 범용 성능은 오히려 떨어질 수 있습니다. 모델을 학습·튜닝할 때 이런 함정에 빠지지 않도록 다양한 평가 지표를 병행하는 게 안전합니다.
남은 과제
이번 독파모 2차 평가는 예정대로 2곳을 선정하며 일단락됐지만, 평가 투명성에 대한 요구는 여전히 남아 있습니다. 국책 AI 사업처럼 공적 자금이 투입되는 선발 과정일수록, 벤치마크 점수 하나로 승부를 가르기보다 실사용성까지 포괄하는 평가 체계와 그 과정의 투명한 공개가 함께 요구되고 있다는 걸 이번 사례가 보여줍니다.